ボストンの住宅価格を単回帰分析で予測してみた
前回数値予測が可能なサンプルデータセットをやろうと記事にしていましたが、 候補データを選定しました。町の住宅価格の中央値を周辺環境から予測するといった 回帰分析向けのサンプルデータになります。場所はボストンで1970年代とかなり古めのデータになっています。 以前活用したときは例のごとくデータの各属性の意味をあまり調べずに使っていたので 今回はきちんと理解するようにしました。英語の翻訳も極力元の意味に近いようにと考えたつもりです。
- 1. 利用データ説明
- 2. どのような分析ができそうか
- 3. Checking Boston housing prices corrected dataset
- 4. check package versions
- 5. 考察
1. 利用データ説明
何のデータか
今回のサンプルデータはBoston housing prices correctedというデータセットになります。
元は1970年のボストン標準都市統計地区のデータで、ボストン郊外または市内の住宅価格のデータになります。 1978年にHarrison and Rubinfeldによってデータが修正され緯度経度を追加したデータが公開されました。
Each record in the database describes a Boston suburb or town. The data was drawn from the Boston Standard Metropolitan Statistical Area (SMSA) in 1970. 参照: https://www.kaggle.com/vikrishnan/boston-house-prices
データ取得先はどこ
Carnegie Mellon Universityから取得します。 boston_corrected.txtから入手可能です。
Source¶ This file contains the Harrison and Rubinfeld (1978) data corrected for a few minor errors and augmented with the latitude and longitude of the observations. This file appears under boston in the statlib index. One can obtain matlab and spreadsheet versions of the information below from www.finance.lsu/re under spatial statistics links.
もしくはRのspDataパッケージでも読み込み可能です。
PythonからRのコードを呼び出す方法は今度記事にしようと思います。
どのようなデータか
データ数: 506レコード
変数一覧:
| # | 英名 | 日本語訳 | 備考 |
|---|---|---|---|
| 0 | OBS. | 行番号 | |
| 1 | TOWN | 町名 | |
| 2 | TOWN# | 町番号 | |
| 3 | TRACT | 土地番号 | |
| 4 | LON | 経度 | |
| 5 | LAT | 緯度 | |
| 6 | MEDV | 持家住宅の価格(1000USD単位) | |
| 7 | CMEDV | 修正済みMEDV | |
| 8 | CRIM | 1人当たりの犯罪数 | |
| 9 | ZN | 町別の25,000平方フィート(7600m2)以上の住居区画の割合 | |
| 10 | INDUS | 町別の非小売業が占める土地面積の割合 | |
| 11 | CHAS | チャールズ川沿いかどうか | 1:川沿い、0:川沿いではない |
| 12 | NOX | 町別の窒素酸化物の濃度(1000万分の1) | 窒素酸化物とは一酸化窒素(NO)と二酸化窒素(NO2)などのことを指す |
| 13 | RM | 住居の平均部屋数 | |
| 14 | AGE | 持ち家住宅 | |
| 15 | DIS | 5つのボストン雇用センターへの重み付き距離 | |
| 16 | RAD | 町別の環状高速道路へのアクセスのしやすさ | |
| 17 | TAX | 町別の$10,000ドルあたりの固定資産税率 | |
| 18 | PTRATIO | 町別の生徒と先生の比率 | |
| 19 | B | 1000*(黒人人口割合 - 0.63)2 | 割合が低いとスコアが高くなるようになっている。 |
| 20 | LSTAT | 貧困人口割合 |
位置情報確認 (Tableau Public 利用)

- Boston市内は住宅価格も固定資産税も高め
- 郊外でも住宅価格が高い物件もある
2. どのような分析ができそうか
- 町の住宅価格の中央値と各属性の関係 (集計ベース)
- 町の住宅価格の中央値を周辺環境から予測する (モデリング)
3. Checking Boston housing prices corrected dataset
パッケージのインポート
import seaborn as sns
import statsmodels.api as sm
import pandas as pd
データの読み込み
df = pd.read_csv("http://lib.stat.cmu.edu/datasets/boston_corrected.txt",skiprows=9,sep="\t")
※ 22年2月1日更新: UnicodeDecodeErrorが発生する方はencoding='Windows-1252'を追加してください。 詳細は下記新ブログをご参照ください。
pd.DataFrame(df.columns)
Out[0]
| 0 | |
|---|---|
| 0 | OBS. |
| 1 | TOWN |
| 2 | TOWN# |
| 3 | TRACT |
| 4 | LON |
| 5 | LAT |
| 6 | MEDV |
| 7 | CMEDV |
| 8 | CRIM |
| 9 | ZN |
| 10 | INDUS |
| 11 | CHAS |
| 12 | NOX |
| 13 | RM |
| 14 | AGE |
| 15 | DIS |
| 16 | RAD |
| 17 | TAX |
| 18 | PTRATIO |
| 19 | B |
| 20 | LSTAT |
df.head(3)
Out[0]
| OBS. | TOWN | TOWN# | TRACT | LON | LAT | MEDV | CMEDV | CRIM | ZN | INDUS | CHAS | NOX | RM | AGE | DIS | RAD | TAX | PTRATIO | B | LSTAT | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | Nahant | 0 | 2011 | -70.955 | 42.2550 | 24.0 | 24.0 | 0.00632 | 18.0 | 2.31 | 0 | 0.538 | 6.575 | 65.2 | 4.0900 | 1 | 296 | 15.3 | 396.90 | 4.98 |
| 1 | 2 | Swampscott | 1 | 2021 | -70.950 | 42.2875 | 21.6 | 21.6 | 0.02731 | 0.0 | 7.07 | 0 | 0.469 | 6.421 | 78.9 | 4.9671 | 2 | 242 | 17.8 | 396.90 | 9.14 |
| 2 | 3 | Swampscott | 1 | 2022 | -70.936 | 42.2830 | 34.7 | 34.7 | 0.02729 | 0.0 | 7.07 | 0 | 0.469 | 7.185 | 61.1 | 4.9671 | 2 | 242 | 17.8 | 392.83 | 4.03 |
データの概要把握
df.describe()
Out[0]
| OBS. | TOWN# | TRACT | LON | LAT | MEDV | CMEDV | CRIM | ZN | INDUS | CHAS | NOX | RM | AGE | DIS | RAD | TAX | PTRATIO | B | LSTAT | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 | 506.000000 |
| mean | 253.500000 | 47.531621 | 2700.355731 | -71.056389 | 42.216440 | 22.532806 | 22.528854 | 3.613524 | 11.363636 | 11.136779 | 0.069170 | 0.554695 | 6.284634 | 68.574901 | 3.795043 | 9.549407 | 408.237154 | 18.455534 | 356.674032 | 12.653063 |
| std | 146.213884 | 27.571401 | 1380.036830 | 0.075405 | 0.061777 | 9.197104 | 9.182176 | 8.601545 | 23.322453 | 6.860353 | 0.253994 | 0.115878 | 0.702617 | 28.148861 | 2.105710 | 8.707259 | 168.537116 | 2.164946 | 91.294864 | 7.141062 |
| min | 1.000000 | 0.000000 | 1.000000 | -71.289500 | 42.030000 | 5.000000 | 5.000000 | 0.006320 | 0.000000 | 0.460000 | 0.000000 | 0.385000 | 3.561000 | 2.900000 | 1.129600 | 1.000000 | 187.000000 | 12.600000 | 0.320000 | 1.730000 |
| 25% | 127.250000 | 26.250000 | 1303.250000 | -71.093225 | 42.180775 | 17.025000 | 17.025000 | 0.082045 | 0.000000 | 5.190000 | 0.000000 | 0.449000 | 5.885500 | 45.025000 | 2.100175 | 4.000000 | 279.000000 | 17.400000 | 375.377500 | 6.950000 |
| 50% | 253.500000 | 42.000000 | 3393.500000 | -71.052900 | 42.218100 | 21.200000 | 21.200000 | 0.256510 | 0.000000 | 9.690000 | 0.000000 | 0.538000 | 6.208500 | 77.500000 | 3.207450 | 5.000000 | 330.000000 | 19.050000 | 391.440000 | 11.360000 |
| 75% | 379.750000 | 78.000000 | 3739.750000 | -71.019625 | 42.252250 | 25.000000 | 25.000000 | 3.677082 | 12.500000 | 18.100000 | 0.000000 | 0.624000 | 6.623500 | 94.075000 | 5.188425 | 24.000000 | 666.000000 | 20.200000 | 396.225000 | 16.955000 |
| max | 506.000000 | 91.000000 | 5082.000000 | -70.810000 | 42.381000 | 50.000000 | 50.000000 | 88.976200 | 100.000000 | 27.740000 | 1.000000 | 0.871000 | 8.780000 | 100.000000 | 12.126500 | 24.000000 | 711.000000 | 22.000000 | 396.900000 | 37.970000 |
Feature Engineering
データの概要把握 その2
# 全体のパーセンタイル確認
# パーセンタイルを確認することにより各属性のデータの入り方を俯瞰できる。
df.quantile([0,0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8,0.9,0.95,0.99,1])
Out[0]
| OBS. | TOWN# | TRACT | LON | LAT | MEDV | CMEDV | CRIM | ZN | INDUS | CHAS | NOX | RM | AGE | DIS | RAD | TAX | PTRATIO | B | LSTAT | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 1.00 | 0.00 | 1.00 | -71.28950 | 42.03000 | 5.00 | 5.00 | 0.006320 | 0.0 | 0.46 | 0.0 | 0.385 | 3.5610 | 2.90 | 1.12960 | 1.0 | 187.0 | 12.60 | 0.320 | 1.7300 |
| 0.10 | 51.50 | 8.00 | 702.50 | -71.14325 | 42.13915 | 12.75 | 12.90 | 0.038195 | 0.0 | 2.91 | 0.0 | 0.427 | 5.5935 | 26.95 | 1.62830 | 3.0 | 233.0 | 14.75 | 290.270 | 4.6800 |
| 0.20 | 102.00 | 24.00 | 1002.00 | -71.10800 | 42.16980 | 15.30 | 15.30 | 0.064170 | 0.0 | 4.39 | 0.0 | 0.442 | 5.8370 | 37.80 | 1.95120 | 4.0 | 273.0 | 16.60 | 364.310 | 6.2900 |
| 0.30 | 152.50 | 28.00 | 2021.50 | -71.08225 | 42.18900 | 18.20 | 18.20 | 0.099245 | 0.0 | 5.96 | 0.0 | 0.472 | 5.9505 | 52.40 | 2.25965 | 4.0 | 289.0 | 17.80 | 378.665 | 7.7650 |
| 0.40 | 203.00 | 36.00 | 2113.00 | -71.06670 | 42.20180 | 19.70 | 19.70 | 0.150380 | 0.0 | 7.38 | 0.0 | 0.507 | 6.0860 | 65.40 | 2.64030 | 5.0 | 307.0 | 18.40 | 387.970 | 9.5300 |
| 0.50 | 253.50 | 42.00 | 3393.50 | -71.05290 | 42.21810 | 21.20 | 21.20 | 0.256510 | 0.0 | 9.69 | 0.0 | 0.538 | 6.2085 | 77.50 | 3.20745 | 5.0 | 330.0 | 19.05 | 391.440 | 11.3600 |
| 0.60 | 304.00 | 57.00 | 3532.00 | -71.04250 | 42.22770 | 22.70 | 22.70 | 0.550070 | 0.0 | 12.83 | 0.0 | 0.575 | 6.3760 | 85.90 | 3.87500 | 5.0 | 398.0 | 19.70 | 393.530 | 13.3300 |
| 0.70 | 354.50 | 72.50 | 3671.50 | -71.02985 | 42.24310 | 24.15 | 24.15 | 1.728440 | 0.0 | 18.10 | 0.0 | 0.605 | 6.5025 | 91.80 | 4.54040 | 8.0 | 437.0 | 20.20 | 395.465 | 15.6200 |
| 0.80 | 405.00 | 80.00 | 3851.00 | -71.00400 | 42.27150 | 28.20 | 28.20 | 5.581070 | 20.0 | 18.10 | 0.0 | 0.668 | 6.7500 | 95.60 | 5.61500 | 24.0 | 666.0 | 20.20 | 396.900 | 18.0600 |
| 0.90 | 455.50 | 83.00 | 4161.50 | -70.96400 | 42.29925 | 34.80 | 34.65 | 10.753000 | 42.5 | 19.58 | 0.0 | 0.713 | 7.1515 | 98.80 | 6.81660 | 24.0 | 666.0 | 20.90 | 396.900 | 23.0350 |
| 0.95 | 480.75 | 86.75 | 4202.75 | -70.93600 | 42.31985 | 43.40 | 43.40 | 15.789150 | 80.0 | 21.89 | 1.0 | 0.740 | 7.5875 | 100.00 | 7.82780 | 24.0 | 666.0 | 21.00 | 396.900 | 26.8075 |
| 0.99 | 500.95 | 90.00 | 5051.95 | -70.85310 | 42.34600 | 50.00 | 50.00 | 41.370330 | 90.0 | 25.65 | 1.0 | 0.871 | 8.3350 | 100.00 | 9.22277 | 24.0 | 666.0 | 21.20 | 396.900 | 33.9185 |
| 1.00 | 506.00 | 91.00 | 5082.00 | -70.81000 | 42.38100 | 50.00 | 50.00 | 88.976200 | 100.0 | 27.74 | 1.0 | 0.871 | 8.7800 | 100.00 | 12.12650 | 24.0 | 711.0 | 22.00 | 396.900 | 37.9700 |
# TOWN#(町番号)とTOWN(町名)の一覧
# 92のユニークなボストン市の町のデータが存在
df[["TOWN#","TOWN"]].drop_duplicates().count()
Out[0]
    TOWN#    92
    TOWN     92
    dtype: int64
# 町の内訳
df[["TOWN#","TOWN"]].drop_duplicates().sort_values(["TOWN#"])["TOWN"].head()
Out[0]
    0         Nahant
    1     Swampscott
    3     Marblehead
    6          Salem
    13          Lynn
    Name: TOWN, dtype: object
# 町別の住宅件数
# TODO:構成費と累積も出したい
# TODO:図で出せるようにする
df[["TOWN#","TOWN"]].groupby(["TOWN"])["TOWN"].count().sort_values(ascending=False).head()
Out[0]
    TOWN
    Cambridge            30
    Boston Savin Hill    23
    Lynn                 22
    Boston Roxbury       19
    Newton               18
    Name: TOWN, dtype: int64
# TRACT(土地番号)の一覧
# 506のユニークな土地番号 = レコード数と一致
df[["TRACT"]].drop_duplicates().count()
Out[0]
    TRACT    506
    dtype: int64
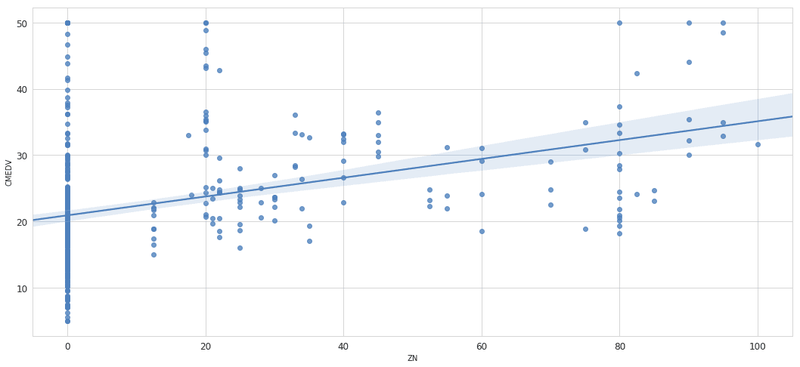
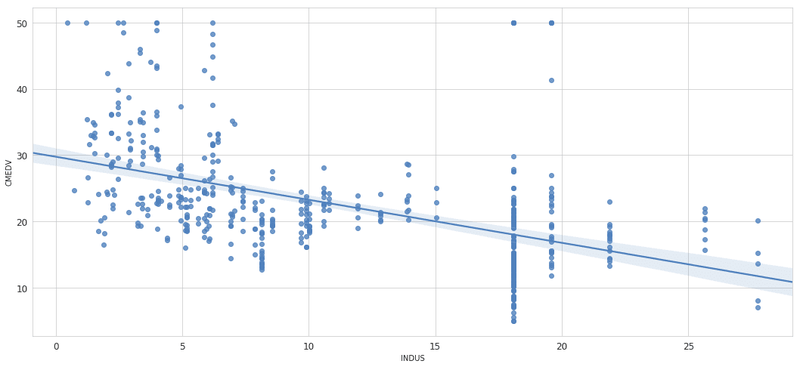
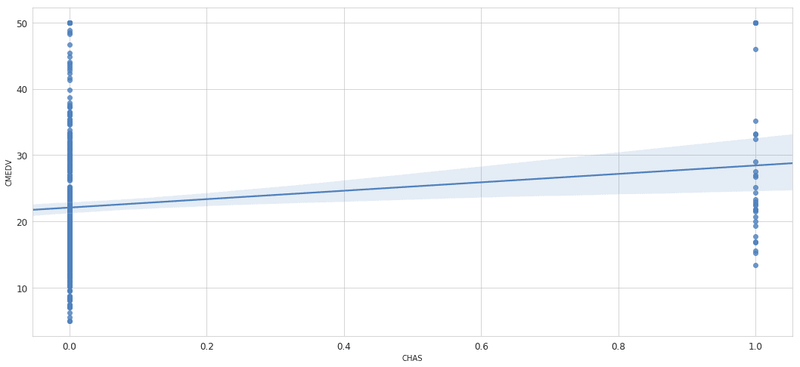
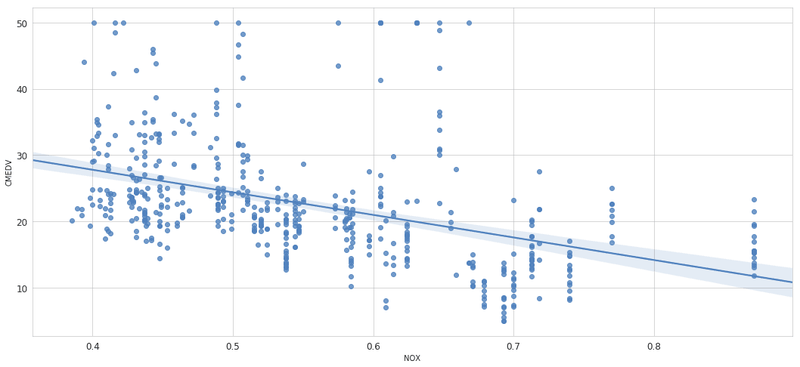
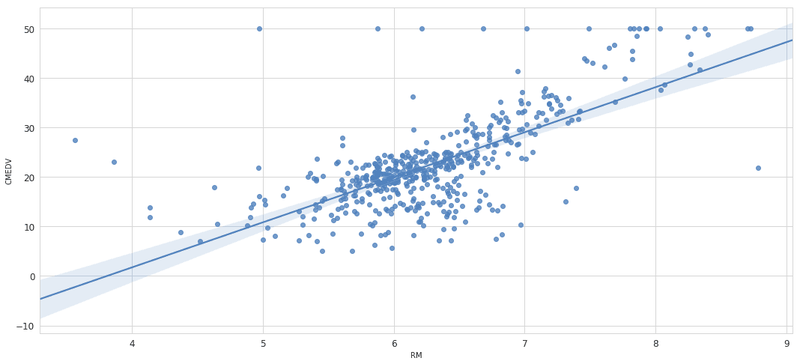
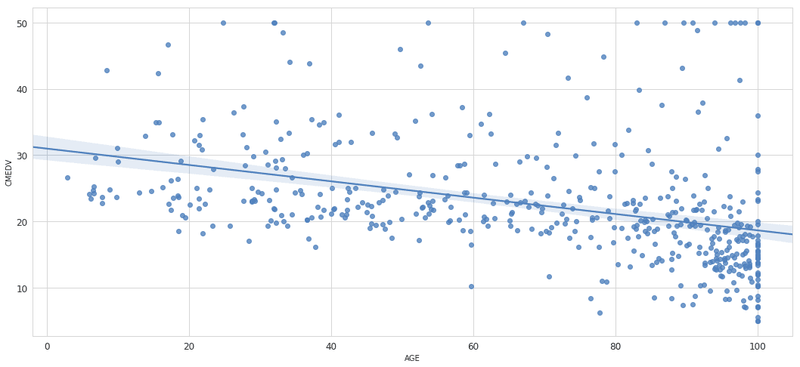
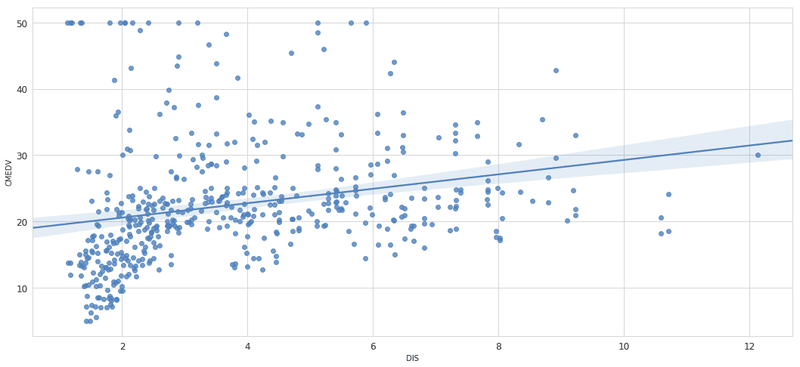
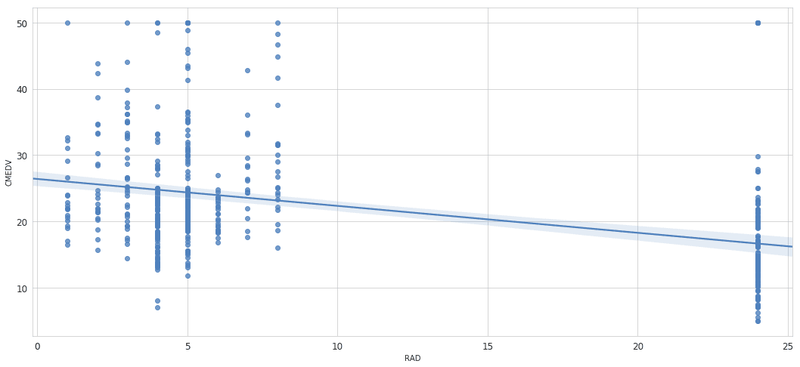
データの概要把握 調整済み住宅価格の中央値と各説明変数の関係
図にして視覚的に確認する
# 描画設定
from matplotlib import rcParams
rcParams['xtick.labelsize'] = 12       # x軸のラベルのフォントサイズ
rcParams['ytick.labelsize'] = 12       # y軸のラベルのフォントサイズ
rcParams['figure.figsize'] = 18,8      # 画像サイズの変更(inch)
cols=[
     #   'OBS.'
     # , 'TOWN'
     # , 'TOWN#'
     # , 'TRACT'
     # , 'LON'
     # , 'LAT'
     # , 'MEDV'
     # , 'CMEDV'
        'CRIM'
      , 'ZN'
      , 'INDUS'
      , 'CHAS'
      , 'NOX'
      , 'RM'
      , 'AGE'
      , 'DIS'
      , 'RAD'
      , 'TAX'
      , 'PTRATIO'
      , 'B'
      , 'LSTAT'
    ]
import matplotlib.pyplot as plt
from matplotlib import ticker
sns.set_style("whitegrid")             # seabornのスタイルセットの一つ
sns.set_color_codes()                  # デフォルトカラー設定 (deepになってる)

for i in cols:
  print(i)
  ax = sns.regplot(x=df[i], y=df["CMEDV"], data=df,color='#4F81BD')
  plt.show()
Out[0]
CRIM

ZN

INDUS
CHAS
NOX
RM
AGE
DIS
RAD
TAX
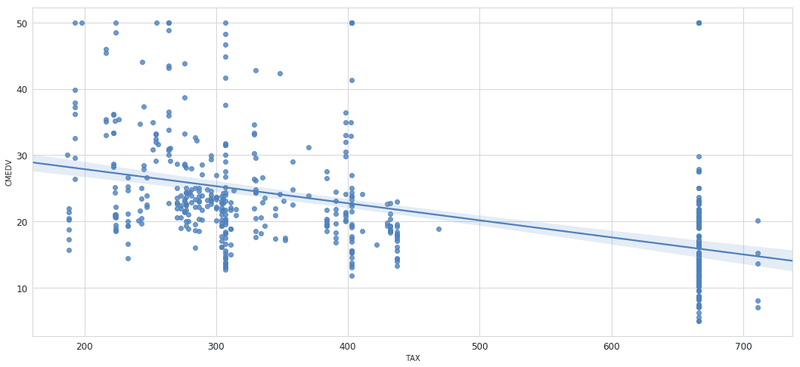
PTRATIO
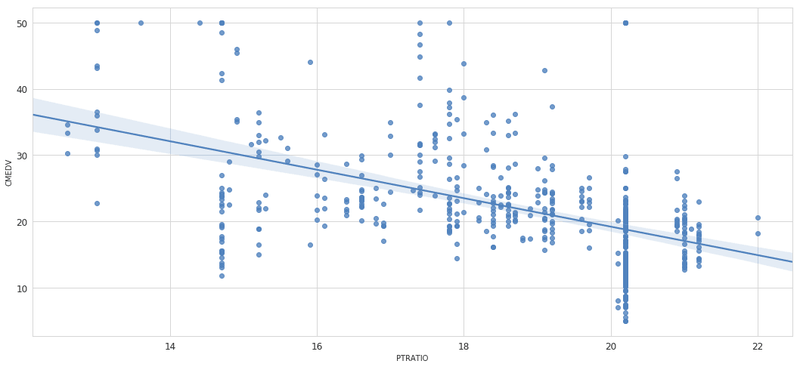
B
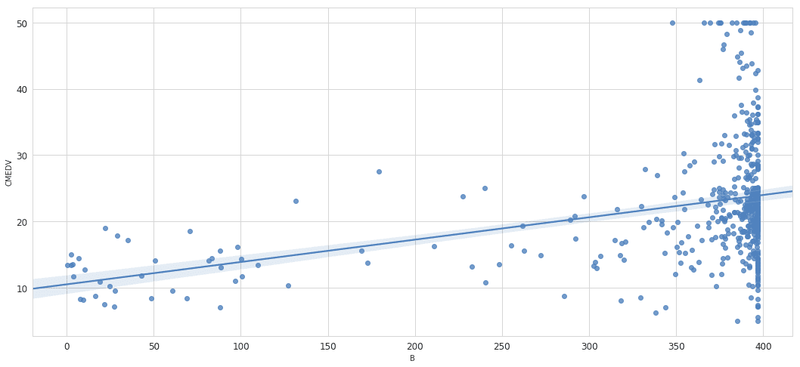
LSTAT
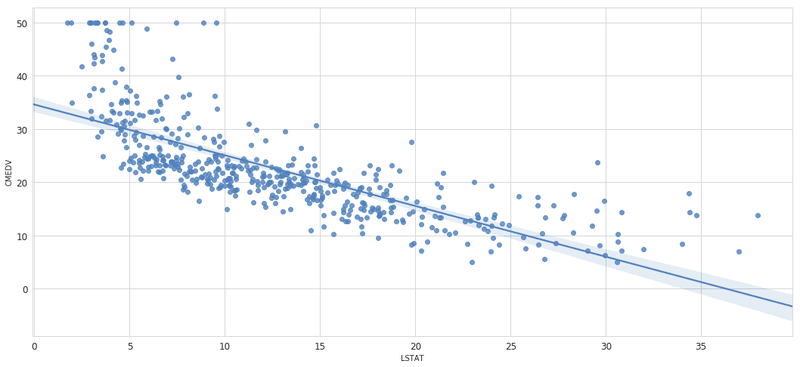
俯瞰結果まとめ
- 部屋数と住宅価格は正の相関がありそう
- 窒素酸化物の濃度と住宅価格は負の相関がありそう
- 貧困人口割合と住宅価格は強い負の相関がありそう
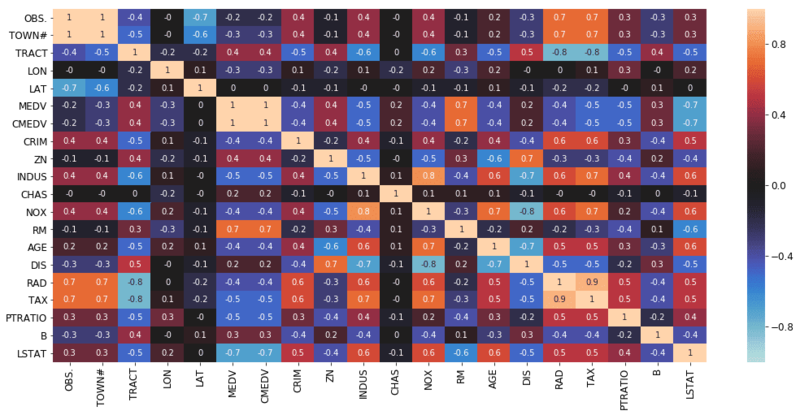
相関係数確認
# df.describe()やregplot()で確認した結果が表されている
sns.heatmap(round(df.corr(),1), vmax=1, vmin=-1, center=0,annot=True)
モデリング
まずは定番な単回帰から試してみる
サンプリング (訓練データ、テストデータ分割)
# 訓練データとテストデータに分割する。
# 本当は町ごとにサンプリングした方がいいと思うが、TODOにしておく。
from sklearn.model_selection import train_test_split
# TODO:層別サンプリング train, test = train_test_split(df, test_size=0.20, stratify=df["町区分"], random_state=100)
train, test = train_test_split(df, test_size=0.20,random_state=100)
# 訓練データの件数確認
train.count()["OBS."]
Out[0]
404
# テストデータの件数確認
test.count()["OBS."]
Out[0]
102
訓練データ、テストデータ作成
X_train = train["LSTAT"].values.reshape(-1,1) #身分が低い人口割合
Y_train = train["CMEDV"] #修正済み住宅価格中央値
X_test = test["LSTAT"].values.reshape(-1,1)
Y_test = test["CMEDV"]
モデル作成
import numpy as np
from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(X_train,Y_train)
Out[0]
LinearRegression(copy_X=True, fit_intercept=True, n_jobs=None, normalize=False)
精度確認
# 自由度調整済みr2を算出
def adjusted_r2(X,Y,model):
   from sklearn.metrics import r2_score
   import numpy as np
   r_squared = r2_score(Y, model.predict(X))
   adjusted_r2 = 1 - (1-r_squared)*(len(Y)-1)/(len(Y)-X.shape[1]-1)
   #yhat = model.predict(X) \ #SS_Residual = sum((Y-yhat)**2) \ #SS_Total = sum((Y-np.mean(Y))**2)
   #r_squared = 1 - (float(SS_Residual))/ SS_Total
   return adjusted_r2

# 予測モデルの精度確認の各種指標を算出
def get_model_evaluations(X_train,Y_train,X_test,Y_test,model):
   from sklearn.metrics import explained_variance_score
   from sklearn.metrics import mean_absolute_error
   from sklearn.metrics import mean_squared_error
   from sklearn.metrics import mean_squared_log_error
   from sklearn.metrics import median_absolute_error

   # 評価指標確認
   # 参考: https://funatsu-lab.github.io/open-course-ware/basic-theory/accuracy-index/
   yhat_test = model.predict(X_test)
   return  "adjusted_r2(train)     :" + str(adjusted_r2(X_train,Y_train,model)) \
         , "adjusted_r2(test)      :" + str(adjusted_r2(X_test,Y_test,model)) \
         , "平均誤差率(test)       :" + str(np.mean(abs(Y_test / yhat_test - 1))) \
         , "MAE(test)              :" + str(mean_absolute_error(Y_test, yhat_test)) \
         , "MedianAE(test)         :" + str(median_absolute_error(Y_test, yhat_test)) \
         , "RMSE(test)             :" + str(np.sqrt(mean_squared_error(Y_test, yhat_test))) \
         , "RMSE(test) / MAE(test) :" + str(np.sqrt(mean_squared_error(Y_test, yhat_test)) / mean_absolute_error(Y_test, yhat_test)) #better if result = 1.253
get_model_evaluations(X_train,Y_train,X_test,Y_test,model)
Out[0]
    ('adjusted_r2(train)     :0.5450083112199139',
     'adjusted_r2(test)      :0.5484843083873783',
     '平均誤差率(test)        :0.2071400734606484',
     'MAE(test)              :4.649849603463476',
     'MedianAE(test)         :3.5061484410406063',
     'RMSE(test)             :6.567724751772347',
     'RMSE(test) / MAE(test) :1.4124596087753734')
MAEで確認すると4,600ドル誤差がある。
plt.figure()
ax = sns.regplot(x=Y_test, y=model.predict(X_test), fit_reg=False,color='#4F81BD')
ax.set_xlabel(u"CMEDV")
ax.set_ylabel(u"(Predicted) CMEDV")
ax.get_xaxis().set_major_formatter(ticker.FuncFormatter(lambda x, p: format(int(x), ',')))
ax.get_yaxis().set_major_formatter(ticker.FuncFormatter(lambda y, p: format(int(y), ',')))
ax.plot([0,10,20,30,40,50],[0,10,20,30,40,50], linewidth=2, color="#C0504D",ls="--")
Out[0]
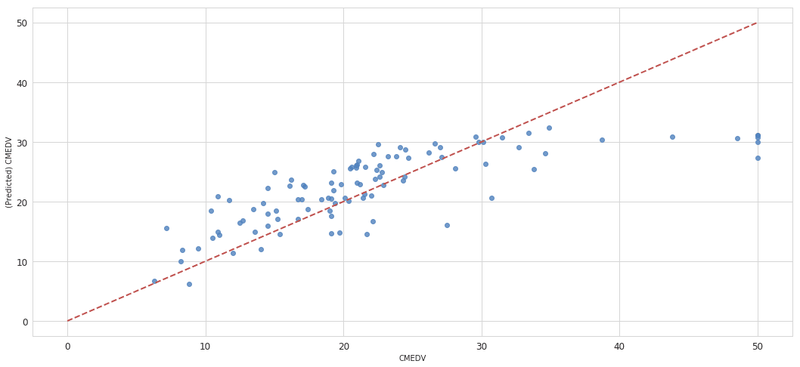
一変数だけ利用した予測モデルとしてはよい結果だとは思うが、誤差が大きく実業務で活用するのは難しそう

4. check package versions
分析環境はanaconda macosです。 conda --version の結果はconda 4.7.12です。
今回利用したパッケージのバージョンは下記です。
import seaborn
import matplotlib
import sklearn
import pandas
import numpy
print("seaborn:"+ seaborn.__version__)
print("matplotlib:"+ matplotlib.__version__)
print("sklearn:"+ sklearn.__version__)
print("pandas:"+ pandas.__version__)
print("numpy:"+ numpy.__version__)
Out[0]
seaborn:0.9.0
matplotlib:3.1.0
sklearn:0.21.2
pandas:0.24.2
numpy:1.16.4
5. 考察
今回は単純な回帰分析ですが、データの理解もできましたので 精度向上を目指して色々試してみてもいいかもしれません。
